รู้จัก Query Store บน SQL Server
หนึ่งในความสามารถที่เพิ่มเข้ามาใน SQL Server ในเวอร์ชั่น 2016 ก็คือ เรื่อง Query Store ซึ่งผู้เขียนตื่นตาตื่นใจมาก เพราะช่วยให้ข้อมูลเชิงลึกของการเลือกใช้ Execution Plan ที่อาจ แตกต่างกันไปในหนึ่งช่วงเวลา ของแต่ละ Query และให้ข้อมูลประสิทธิภาพจากการเลือกใช้ Execution Plan นั้น ๆ เก็บไว้ให้วิเคราะห์ โดยปกติแล้ว หากสภาวะแวดล้อมต่าง ๆ ไม่เปลี่ยนแปลงไปเลย (ซึ่งเป็นไปไม่ได้ เพราะทุกอย่างเปลี่ยนแปลงไปตามกาลเวลา) การ Query ยังคงเดิม ก็น่าจะได้ Execution Plan เดิม แต่หากสภาวะแวดล้อมเปลี่ยนแปลงไป Database Engine ก็จะทำการเลือก Execution Plan ตัวใหม่มาแทนตัวเก่า ซึ่งการเปลี่ยน Plan ตามกาลเวลาเหล่านี้จะถูกบันทึกไว้ใน Query Store และเป็นประโยชน์อย่างมาก
สิ่งที่ทำให้ Execution Plan ของ Query ตัวเดิม เปลี่ยนแปลงไปตามกาลเวลา มักเกิดจากการปรับปรุงค่าใน Statistics ตัวที่ Query นั้น ๆ ต้องใช้ประกอบการพิจารณาหา Cost ของ Plan ต่าง ๆ ที่เข้าชิงเพื่อถูกเลือกนำไปใช้ประมวลผล (โดยจะเลือกตัวที่ให้ Cost ต่ำที่สุด)
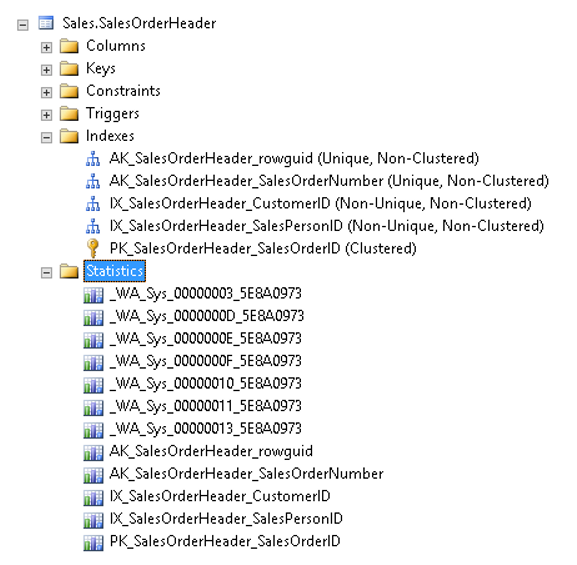
รูปภาพ แสดงตัวอย่าง Indexes และ Statistics ของตาราง Sales.SalesOrderHeader จากฐานข้อมูล AdventureWorks
Statistics เป็นสิ่งสำคัญมากในการพิจารณาสร้าง Plan ใหม่ นอกจากนั้นการเปลี่ยนแปลงโครงสร้างภายในตารางที่ใช้ในการ Query การเพิ่ม Indexes เข้าไปในตาราง หรือ ลบ Indexes ออกจากตาราง ก็ส่งผล แม้แต่กลไกการทำ Query Optimization ซึ่งจะมีการแคช Execution Plan ที่สัมพันธ์กับ Query เอาไว้ เมื่อ Query นี้ถูกเรียกใช้อีกครั้งก็จะลัดขั้นตอนหลาย ๆ อย่าง เพราะเอา Plan ที่แคชไว้มาประมวลผลทันทีทำให้เสร็จเร็วขึ้น แต่การแคชนี้จะเก็บเอา Plan ที่ดีที่สุดครั้งสุดท้ายเอาไว้ใน Memory เท่านั้น และมีโอกาสถูกโยนทิ้งหาก Memory ไม่เพียงพอ ก็จะกลับมาเพิ่มโอกาสการเกิด Plan ใหม่เพิ่มขึ้นไปอีก
Query Store จะเป็นพระเอกในเรื่องนี้ เพราะการ Query แบบเดิม แต่เกิด Execution Plan ขึ้นใหม่หลาย ๆ Plan ใน 1 ช่วงเวลา จะถูกเก็บบันทึกไว้ และเราสามารถนำมาใช้วิเคราะห์ในสถานการณ์ต่าง ๆ ดังนี้
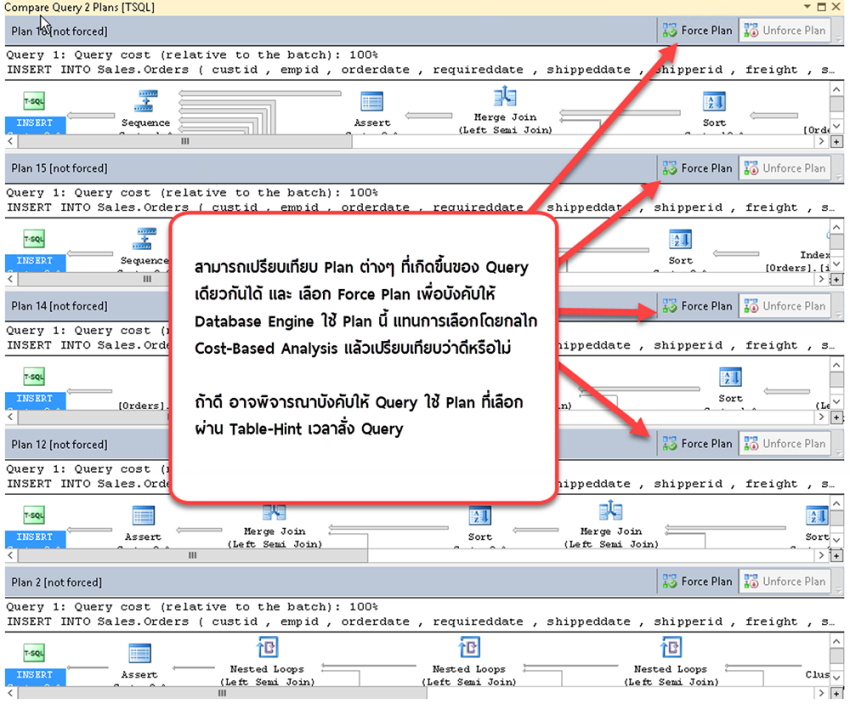
ค้นหาและแก้ไข ในกรณีที่เกิด ความถดถอยด้านประสิทธิภาพของ Query โดยเลือกทำการ Force นำ Plan เก่ากลับมาลองใช้และเปรียบเทียบว่าตัวใดมีประสิทธิภาพดีกว่าหรือตัวใดทำให้ประสิทธิภาพถดถอย
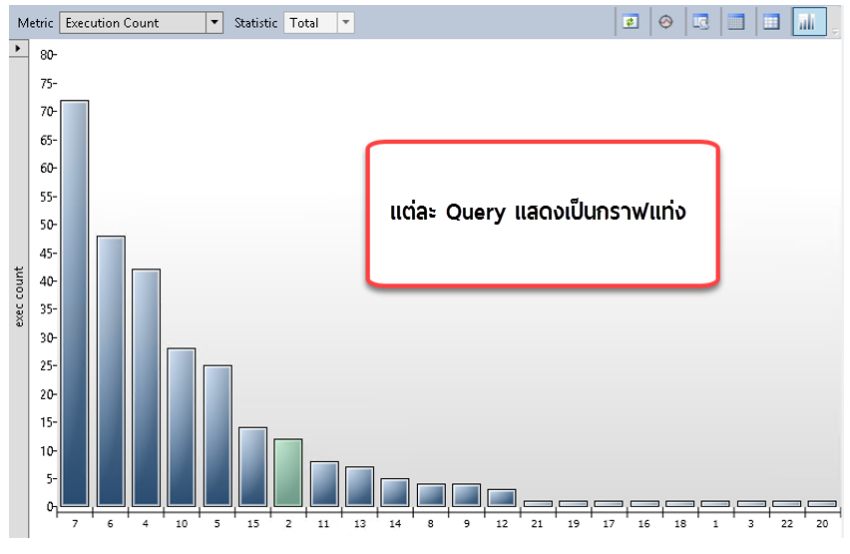
ดูจำนวน Query ที่เกิดขึ้น ในหนึ่งช่วงเวลาเพื่อช่วยวิเคราะห์วางแผนจัดหาทรัพยากรให้เหมาะสม
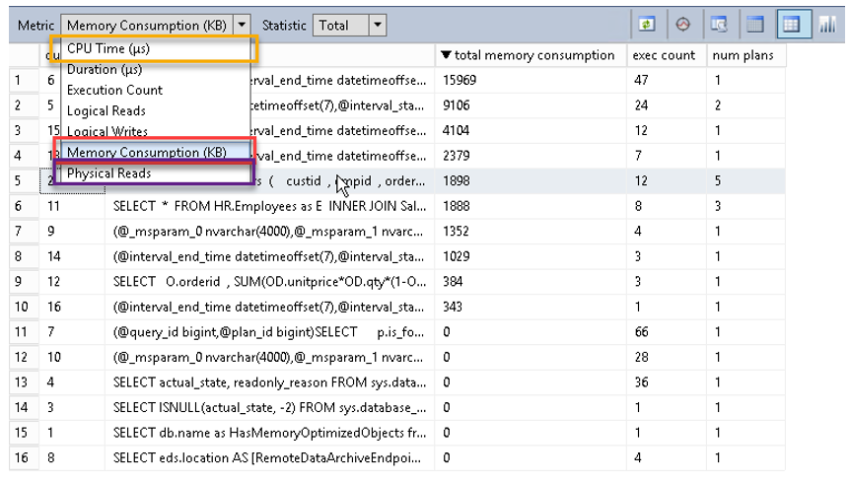
หาว่า Query ตัวใดใช้เวลาในการประมวลผลนาน หรือบริโภคทรัพยากรเป็นจำนวนมาก
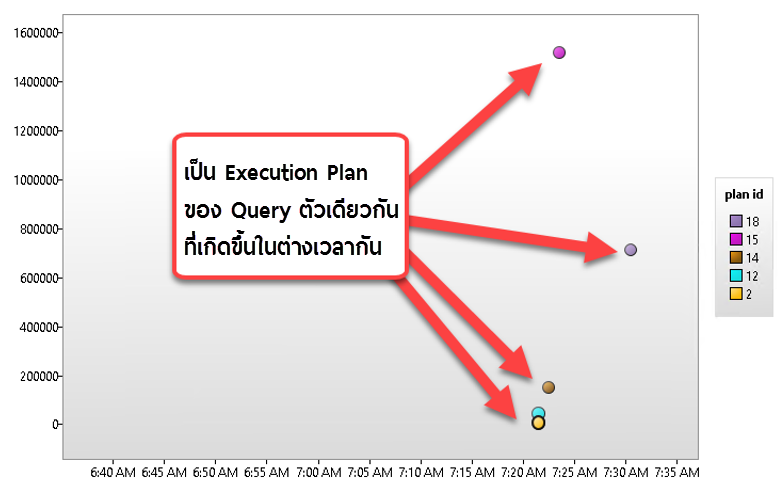
เป็นการเก็บประวัติของ Execution Plan ที่เกิดขึ้นกับ Query ใด
การตั้งค่าให้เก็บ Query Store บนฐานข้อมูลใด
คลิกขวาไปที่ฐานข้อมูลใด ๆ (ตัวอย่างนี้คือฐานข้อมูล AdventureWorks) และเลือกไปที่ Properties จากนั้นเลือกไปที่เพจ Query Store ทดลองกำหนดค่าดังรูป
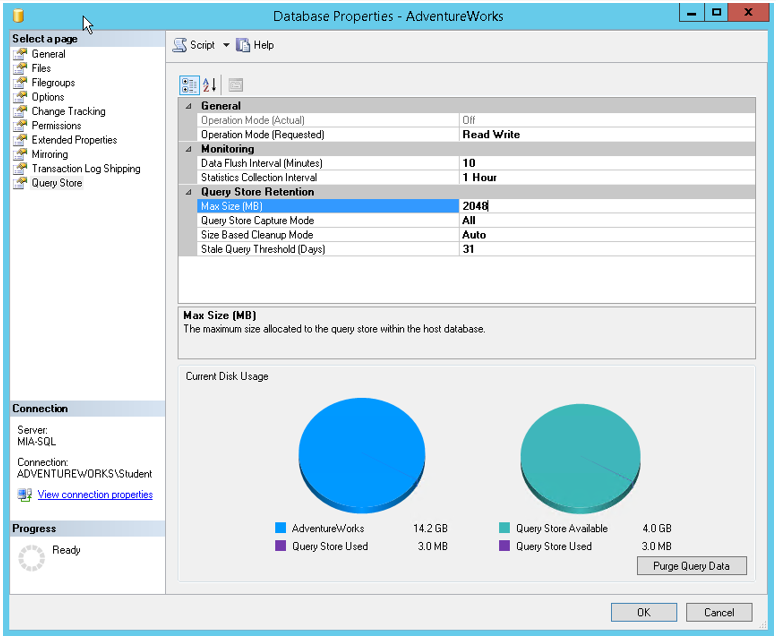
หรือกรณีใช้ Script
        USE master
    GO
    ALTER DATABASE AdvantureWorks
    SET QUERY_STORE = ON
    GO
    ALTER DATABASE AdventureWorks
    SET QUERY_STORE
    (
    OPERATION_MODE = READ_WRITE
    , DATA_FLUSH_INTERVAL_SECONDS = 600
    , INTERVAL_LENGTH_MINUTES = 60
    , MAX_STORAGE_SIZE_MB = 2048
    )
    GO
การตั้งค่า
ค่า | ตัวเลือก | ความหมาย |
Operation Mode | Off | ปิดการใช้งาน Query Store |
Read/Write | เปิดการใช้งาน และรับการบันทึกจนกว่าจะเต็ม Max Storage Size จะเปลี่ยนเป็น Read Only อัตโนมัติ | |
Read Only | รอรับการสลับจากโหมด Read/Write | |
Data Flush Interval | กำหนดเอง | บันทึกการดักรับลงสู่ดิสก์ ทุก ๆ กี่วินาที |
Collection Interval | กำหนดเอง | กำหนดขอบเขตเวลาในการจัดเก็บ |
Max Size | กำหนดเอง | กำหนดขนาดความจุดิสก์ที่รองรับการจัดเก็บ |
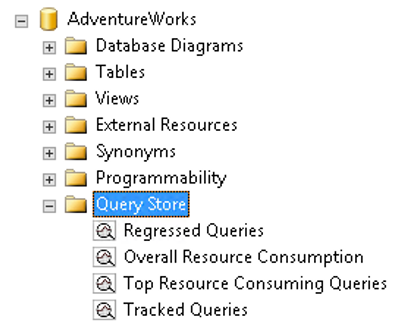
เมื่อตั้งค่าสำเร็จแล้วจะปรากฏโฟลเดอร์ Query Store ในฐานข้อมูลดังรูป
ผู้เขียนลองเลือก Regressed Queries ขึ้นมาดูเป็นตัวอย่าง ดังรูป
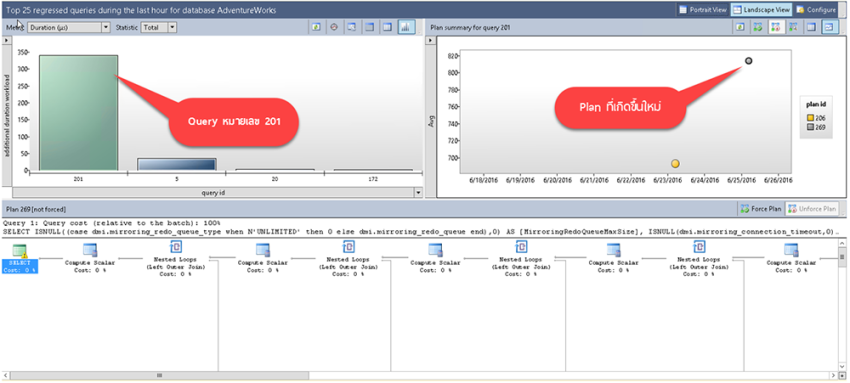
Regressed Queries จะแสดง Query ที่เกิด Plan ใหม่ที่ประสิทธิภาพถดถอยไปจากเดิม
ตัวอย่างนี้ จะเห็น Plan Summary ของ Query หมายเลข 201 จะเห็นว่า Plan แรกใช้เวลาประมวลผลประมาณ 680 microsecond แต่ Plan ที่เกิดขึ้นใหม่ใช้เวลาประมวลผลประมาณ 810 microsecond ซึ่งถือว่าถดถอยลงจากเดิม อาจเกิดจาก
ปริมาณข้อมูลที่มากขึ้นเมื่อเวลาเปลี่ยนไป
มีการแก้ไขโครงสร้าง Index ทำให้เลือก Plan ใหม่
ทั้งหมดเป็นการคาดเดาของผู้เขียนซึ่งนี่แหละเป็นสิ่งที่ต้องไปหาต่อว่าทำไม และที่เปิดโอกาสให้เกิดการค้นหาก็ต้องยกประโยชน์ให้ Query Store
ผู้อ่านสามารถศึกษาเพิ่มเติมและทำตามเอกสารนี้ได้เลย Best Practice with the Query Store